Nový důraz na paměť, ne jen na výpočetní výkon
Ve světě vysoce náročných výpočtů se dlouho mluvilo hlavně o počtu jader, frekvenci a teoretickém výkonu v operacích za sekundu. Jenže u trénování moderních modelů i simulací v praxi často rozhoduje něco jiného: jak rychle se data dostanou k procesoru a zpět. Právě proto se současný vývoj hardwaru soustředí na širší paměťové sběrnice, rychlejší typy pamětí a větší kapacitu přímo u akcelerátorů.
Typickým příkladem je přechod na paměti HBM, tedy High Bandwidth Memory. U nejnovějších grafických a výpočetních akcelerátorů nabízí násobně vyšší propustnost než běžné paměti DDR. Například některé špičkové AI akcelerátory pracují s propustností přes 3 TB/s, což je zásadní při práci s modely o stovkách miliard parametrů. Bez takové kapacity a rychlosti by byl výpočetní výkon čipů z velké části nevyužitý.
Akcelerátory pro umělou inteligenci se odlišují od klasických GPU
Ještě před několika lety se za hlavní motor trénování modelů považovaly především herní nebo profesionální grafické karty. Dnes se ale prosazují specializované akcelerátory, které jsou navržené přímo pro maticové operace, inferenci i distribuované trénování. Výrobci jako Nvidia, AMD, Intel, ale i cloudoví hráči typu Google nebo Amazon investují do čipů, které umějí zpracovávat úlohy efektivněji než univerzální GPU.
Rozdíl je i v tom, že nové čipy často podporují nižší přesnost výpočtů, například FP8 nebo BF16, aniž by výrazně utrpěla kvalita výsledku. To umožňuje zrychlit trénování a snížit spotřebu energie. V praxi to znamená, že úloha, která dříve vyžadovala desítky výkonných serverů, může být dnes zvládnuta v menším počtu strojů, pokud jsou osazeny moderními akcelerátory a mají dostatečně rychlé propojení.
Velkou roli hraje také software. Bez optimalizovaných knihoven, jako jsou CUDA, ROCm nebo různé frameworky pro distribuované učení, by se z výkonu nových čipů využila jen část. Hardware a software se tak vyvíjejí současně a firmy už při nákupu neřeší jen samotný čip, ale celý ekosystém.
Propojení čipů je dnes stejně důležité jako jejich výkon
Jedním z největších omezení při trénování rozsáhlých modelů není jednotlivý procesor, ale komunikace mezi nimi. Pokud se data mezi akcelerátory přesouvají pomalu, výpočet stojí a náklady rostou. Proto se do popředí dostávají nové interconnecty, tedy technologie pro rychlé spojení čipů v rámci jednoho serveru i mezi servery.
Výrobci nasazují vlastní vysokorychlostní sběrnice a síťové technologie s propustností v řádu stovek gigabitů za sekundu. U některých datových center se standardem stává Ethernet 400 Gb/s nebo 800 Gb/s, v případě specializovaných clusterů i proprietární propojení s ještě nižší latencí. U velkých modelů, kde se trénování rozkládá mezi stovky až tisíce čipů, je právě komunikace často rozhodujícím faktorem, zda systém běží efektivně, nebo se výkon ztrácí čekáním na data.
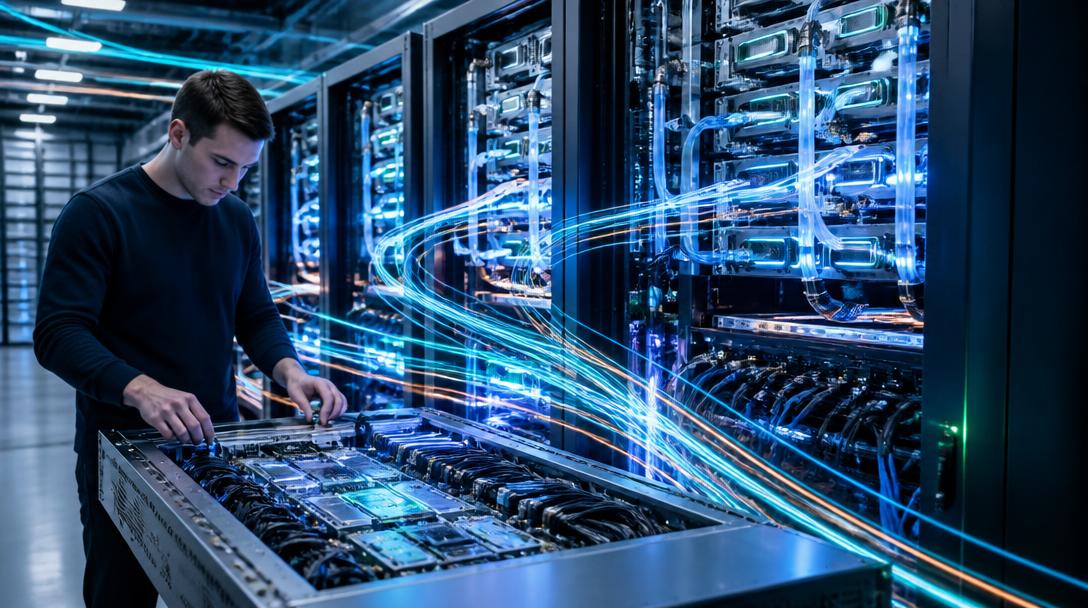
To je také důvod, proč se mění konstrukce serverů. Místo klasických rackových sestav přibývají celé výpočetní platformy s předem daným chlazením, napájením a topologií propojení. Cílem je co nejvíce zkrátit cestu dat a omezit ztráty výkonu při koordinaci mezi jednotlivými uzly.
Nové procesory míří i do superpočítačů a vědeckých simulací
Ačkoli se pozornost veřejnosti soustředí hlavně na umělou inteligenci, nové architektury mají širší dopad. V superpočítačích se používají na klimatické modely, vývoj léčiv, výpočty v materiálovém inženýrství nebo simulace proudění vzduchu. Tam se počítá každé procento efektivity, protože výpočty běží týdny až měsíce.
V posledních letech se prosazují systémy, které kombinují klasické CPU s akcelerátory na jednom nebo několika propojených modulech. Výsledkem je lepší využití energie i prostoru. Například moderní superpočítače dosahují výkonu v exaflopovém řádu, tedy více než miliardy miliard operací za sekundu, ale právě architektura rozhoduje o tom, jaký výkon je dostupný pro konkrétní aplikaci a jaká je reálná produktivita.
U vědeckých institucí je důležitý i přístup k paměti. Velké simulace často potřebují pracovat s obrovskými datovými sadami, které se nevejdou do běžné konfigurace. Proto se vedle výpočetních čipů rozšiřují také paměťově bohaté servery a systémy s rychlým přístupem k úložištím NVMe. Bez toho by ani výkonný hardware nedokázal držet krok s nároky moderních modelů a simulací.
Energetická efektivita se stává hlavním měřítkem
Rostoucí výkon má i odvrácenou stranu: spotřebu energie a nároky na chlazení. Datová centra dnes čelí tlaku na úspornost nejen kvůli cenám elektřiny, ale i kvůli kapacitním limitům sítě a chlazení. Proto se v technických specifikacích stále častěji sleduje výkon na watt, nikoli jen maximální počet operací.
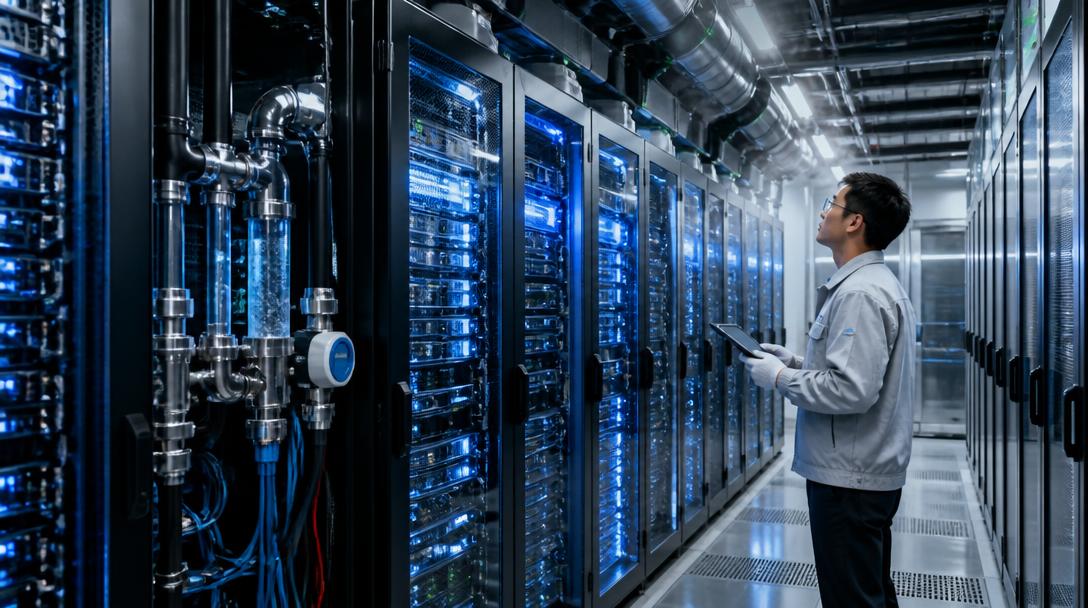
U velkých AI clusterů se spotřeba jednoho racku může pohybovat v desítkách kilowattů a u nejvýkonnějších instalací i výrazně výše. To nutí provozovatele přecházet na kapalinové chlazení, přímé chlazení čipů nebo celé výpočetní moduly navržené pro hustší osazení. Výrobci zároveň optimalizují architektury tak, aby se méně energie ztrácelo při přesunu dat mezi čipy.
Pro firmy je to zásadní ekonomická otázka. Pokud nový systém sice nabídne vyšší výkon, ale zároveň dramaticky zvedne provozní náklady, návratnost investice se prodlužuje. Proto se dnes při výběru hardware sleduje nejen špičkový benchmark, ale i cena za trénování jednoho modelu, spotřeba při inferenci a provozní náklady datového centra.
Co to znamená pro firmy, vývojáře i běžné uživatele
Nové procesory a architektury nejsou jen záležitostí laboratoří a hyperscalerů. Postupně se promítají i do běžných služeb. Rychlejší trénování znamená častější aktualizace modelů, přesnější doporučovací systémy, lepší překlady i rychlejší generování obsahu. Ve firmách zase umožňují kratší vývojové cykly, rychlejší analýzu dat a efektivnější automatizaci.
Vývojáři ale musí počítat s tím, že přechod na novou generaci hardwaru není automatický. Často je nutné upravit software, změnit datové pipeline a optimalizovat kód pro konkrétní architekturu. Některé týmy proto volí hybridní přístup: část úloh běží na CPU, část na GPU a nejnáročnější operace na specializovaných akcelerátorech.
Na trhu se tak rýsuje jasný trend: úspěch už neurčuje jen nejrychlejší čip, ale celý systém od paměti přes propojení až po chlazení a software. Pro výrobce je to závod o efektivitu, pro zákazníky o nižší náklady a vyšší výkon, a pro datová centra o to, zda zvládnou udržet krok s tempem, jakým rostou nároky na výpočetní sílu.