Od univerzálního asistenta ke specializovanému nástroji
Ještě před několika lety se zdálo, že jeden velký jazykový model zvládne téměř vše: napsat e-mail, vysvětlit složitý pojem, shrnout smlouvu i navrhnout postup léčby. Praxe ale ukazuje, že v oborech s vysokou odpovědností nestačí jen „umět mluvit“. Potřebná je přesnost, práce s terminologií, znalost předpisů a schopnost vracet odpovědi, které lze ověřit. Právě v tomto bodě se univerzální umělá inteligence začíná dělit o prostor s modely vytvořenými pro konkrétní odvětví.
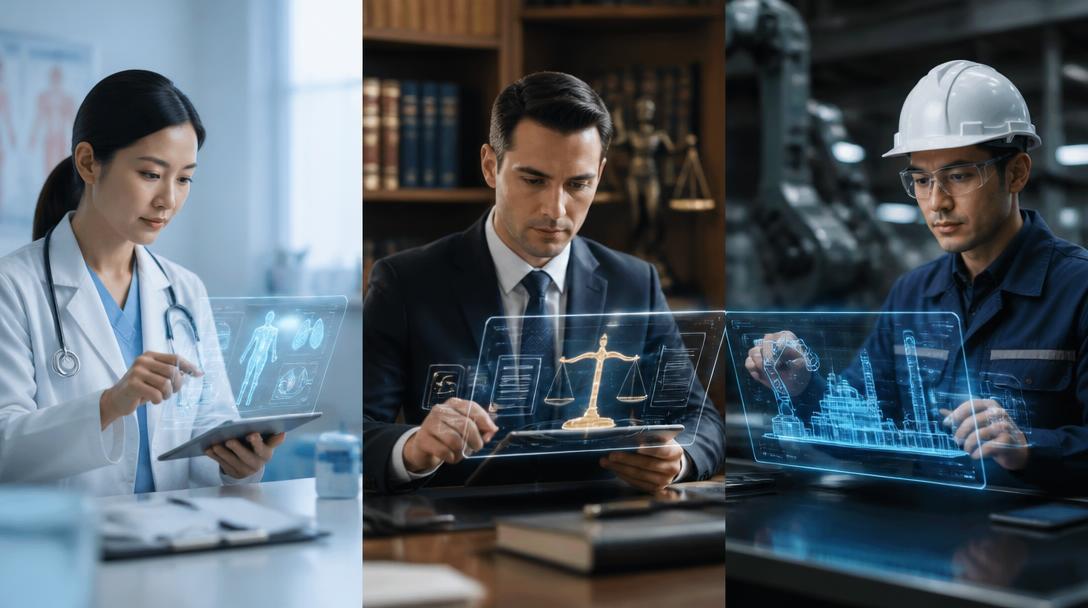
Doménově specifické jazykové modely, často označované jako domain-specific LLMs, jsou trénované nebo dolaďované na odborných datech z medicíny, práva, financí, průmyslu nebo techniky. Místo toho, aby se snažily být dobré ve všem, soustředí se na úzký okruh úloh. V praxi to znamená lepší rozpoznávání odborných termínů, menší chybovost a větší šanci, že výstup bude použitelný v reálném provozu.
Proč univerzální modely v citlivých oborech narážejí
Hlavním problémem velkých univerzálních modelů je takzvaná halucinace, tedy generování přesvědčivě znějících, ale nesprávných nebo neexistujících informací. V běžné konverzaci to může znamenat nepřesnost. V medicíně nebo právu však i drobná odchylka může mít vážné následky. Pokud model zamění dávkování, špatně interpretuje laboratorní hodnotu nebo zkreslí význam smluvní doložky, nejde o drobnou chybu, ale o riziko pro pacienta, klienta nebo firmu.
Dalším limitem je kontext. Univerzální modely bývají trénované na obrovském množství veřejně dostupných dat, ale ne vždy mají přístup k aktuálním interním předpisům, lokální legislativě nebo specifickým výrobním postupům. V právu přitom rozhoduje přesné znění zákona a jeho výklad v konkrétní jurisdikci. V medicíně zase záleží na diagnóze, anamnéze i doporučeních odborných společností. V průmyslu hraje roli typ stroje, výrobní linky nebo materiálu. Bez této znalosti je výstup modelu často příliš obecný.
Podle analytiků z trhu s podnikovou AI se firmy stále častěji přesouvají od „chatovacího“ použití směrem k nástrojům, které jsou napojené na interní data a kontrolované pracovní postupy. Důvod je prostý: univerzální model může být užitečný pro rychlý náčrt, ale v kritickém provozu je potřeba systém, který umí pracovat s omezeným a ověřeným souborem informací.
Medicína: přesnost, dohledatelnost a ochrana pacienta
V medicíně se specializované modely prosazují zejména tam, kde je potřeba rychle procházet velké množství dokumentace. Nemocnice a kliniky testují systémy pro shrnování zdravotních záznamů, třídění pacientských dotazů, podporu radiologie nebo asistenci při kódování diagnóz. V některých případech modely pomáhají lékařům s administrativou, aby se více času věnovalo pacientovi.
Reálný přínos je vidět například při zpracování klinických textů. Zatímco běžný model může zaměnit odborné zkratky nebo přehlédnout kontraindikaci, specializovaný model trénovaný na zdravotnické terminologii lépe rozlišuje mezi symptomem, diagnózou a doporučením. To je zásadní třeba při sumarizaci propouštěcí zprávy nebo při vyhledávání informací v elektronické dokumentaci.
Důležitý je i regulatorní rámec. Ve zdravotnictví se vyžaduje vysoká míra vysvětlitelnosti a auditovatelnosti. Modely proto často fungují v kombinaci s kontrolovanými zdroji, například s nemocniční databází nebo ověřenou klinickou znalostní bází. Nejde jen o to, aby systém odpověděl správně, ale aby bylo možné zpětně doložit, z čeho vycházel. To je rozdíl oproti obecné AI, která často nabízí výsledek bez jasného zdroje.
- Specializované modely se využívají při třídění pacientských dotazů a administrativní podpoře lékařů.
- V radiologii a patologii pomáhají s předvýběrem snímků či textů k rychlejší kontrole.
- V klinické dokumentaci snižují čas potřebný na shrnutí a vyhledávání informací.
Právo: přesná terminologie a práce s jurisdikcí
Právní prostředí je pro univerzální modely mimořádně náročné. Nestačí rozumět jazyku; je třeba znát právní systém, hierarchii norem, aktuální judikaturu a rozdíly mezi jednotlivými státy. Model, který je dobrý v obecné argumentaci, může v právu selhat na detailu, například zaměnit platnost smlouvy, účinnost zákona nebo význam soudního rozhodnutí.
Proto si advokátní kanceláře i compliance oddělení čím dál častěji pořizují specializované nástroje pro konkrétní agendy: analýzu smluv, vyhledávání v judikatuře, kontrolu souladu s předpisy nebo přípravu podkladů pro interní audit. Tyto systémy bývají napojené na ověřené právní databáze, pracují s citacemi a umějí upozornit na nesrovnalosti v textu. V praxi to snižuje čas strávený rutinní rešerší.
Podle zkušeností právních firem není hlavní přínos v tom, že by AI „nahradila právníka“, ale že zrychlí práci juniorních týmů a snižuje náklady na opakované úkony. Pokud model umí vytáhnout relevantní ustanovení ze smlouvy, porovnat verze dokumentu nebo označit rizikové klauzule, zůstává právníkovi prostor pro interpretaci a strategii. V oboru, kde má nepřesnost přímé finanční dopady, je to zásadní posun.
Na trhu se zároveň objevují systémy, které jsou navržené pro jednotlivé právní řády, například pro evropské regulace, americké soudnictví nebo specifické oblasti jako pracovní právo či ochrana osobních údajů. Univerzální model by musel pokrýt příliš mnoho výjimek; specializovaný nástroj se soustředí na jednu oblast a tím bývá přesnější.
Průmysl: méně chyb na lince, více dat z provozu
V průmyslu se doménově specifické modely prosazují hlavně v údržbě, řízení výroby a kontrole kvality. Výrobní podniky pracují s velkým množstvím senzorických dat, servisních protokolů a technické dokumentace. Specializovaný model dokáže propojit údaje ze strojů, historické poruchy a výrobní plán a navrhnout, kde hrozí odstávka nebo jak optimalizovat servisní zásah.
Typickým příkladem je prediktivní údržba. Pokud systém vyhodnotí vibrace motoru, teplotu ložiska a předchozí servisní zásahy, může upozornit na riziko poruchy dřív, než dojde k zastavení linky. V automobilovém, strojírenském nebo chemickém průmyslu to může znamenat úsporu ve stovkách tisíc až milionech korun ročně, zejména pokud se podaří předejít neplánované odstávce.
Specializované modely se uplatňují také při kontrole kvality. Tam, kde je potřeba rozpoznat vadný výrobek podle obrazu nebo kombinace senzorických údajů, bývá úzký model rychlejší a přesnější než univerzální systém. Výhodou je i to, že se dá lépe přizpůsobit konkrétní výrobní lince, materiálu nebo normě. V továrně totiž nezáleží na „obecném“ chování modelu, ale na tom, zda umí rozlišit standardní odchylku od skutečné vady.
- Prediktivní údržba pomáhá snižovat neplánované odstávky výrobních linek.
- Kontrola kvality využívá modely pro rozpoznávání vad na snímcích i v datech ze senzorů.
- Technická podpora těží z modelů, které pracují s manuály, servisní historií a provozními protokoly.
Co rozhoduje o úspěchu: data, regulace a důvěra
Růst specializovaných modelů není jen technologická otázka, ale i otázka důvěry. Firmy i instituce chtějí vědět, odkud model čerpá data, jak často se aktualizuje a kdo odpovídá za jeho výstupy. V citlivých oborech proto roste význam takzvaného „human in the loop“, tedy zapojení člověka do kontroly výsledků. AI má pomáhat, ne rozhodovat bez dozoru.
Vývoj těchto nástrojů navíc zrychluje dostupnost menších a efektivnějších modelů. Ne každá firma potřebuje obrovský univerzální systém. Mnohé podniky dávají přednost řešení, které se dá nasadit lokálně, lépe hlídá data a je levnější na provoz. To je důležité zejména tam, kde se pracuje s citlivými informacemi, obchodním tajemstvím nebo osobními údaji.
Trh se tak posouvá od jediné „všeumějící“ AI k ekosystému nástrojů, které řeší konkrétní problém. V medicíně jde o bezpečnější práci s pacientskými daty, v právu o přesnější analýzu dokumentů a v průmyslu o vyšší provozní spolehlivost. Univerzální modely nezmizely, ale jejich role se mění: z hlavního nástroje se stávají vstupní branou, zatímco skutečnou práci v citlivých oborech přebírají specializované systémy.