AI, která vidí, slyší a rozumí souvislostem
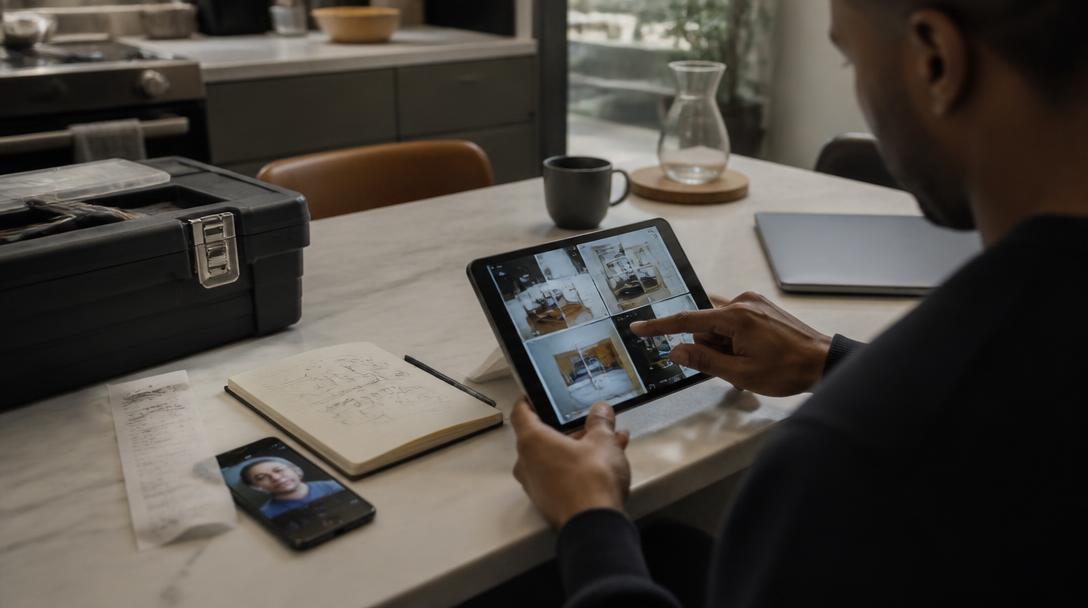
Ještě před několika lety byla většina běžných chatbotů odkázána hlavně na text. Uživatel musel otázku přepsat, popsat problém slovy a doufat, že model pochopí, co má dělat. V roce 2026 se to mění. Multimodální modely zvládají zpracovat několik typů vstupů najednou: text, fotografie, audio, video i data z tabulek. V praxi to znamená, že umělé inteligenci stačí ukázat snímek rozbitého spotřebiče, přiložit krátké video, kde se závada objevuje, a přidat hlasovou poznámku s popisem problému.
Podle firemních i akademických testů dokážou nejpokročilejší modely v řadě úloh navázat význam mezi obrazem a textem s přesností přesahující 80 procent, u některých uzavřených scénářů i více. Nejde o dokonalost, ale o zásadní posun: AI už není jen „textový vyhledávač“, nýbrž nástroj, který propojuje různé zdroje informací a hledá mezi nimi vztahy. To je důležité například v situacích, kdy uživatel neví, jak přesně problém pojmenovat.
Domácnost: od receptu po opravu pračky
Nejviditelnější dopad multimodálních modelů je v každodenních drobnostech. Uživatelé je využívají při vaření, nakupování, plánování i údržbě domácnosti. Stačí vyfotit obsah lednice a model navrhne recepty podle surovin, času i dietních omezení. Když člověk pošle snímek účtenky, umělá inteligence rozpozná položky, roztřídí výdaje a upozorní na neobvyklé platby. V chytrých telefonech už je běžné, že model umí z fotografie odhadnout typ spotřebiče, dohledat manuál a vysvětlit, co znamená chybový kód.
Praktický přínos je hlavně v rychlosti. Místo hledání v internetových fórech nebo procházení návodů dostane uživatel odpověď během několika sekund. Firmy, které multimodální asistenty nasazují do zákaznické podpory, uvádějí zkrácení času na vyřešení běžného dotazu o 30 až 50 procent. V domácím prostředí jde sice o méně měřitelný efekt, ale princip je stejný: model sníží počet kroků mezi problémem a řešením.
- Fotka závady: model rozpozná typ poruchy a navrhne postup.
- Hlasový dotaz: uživatel nemusí nic psát, stačí krátký záznam.
- Kombinace více vstupů: obraz, text a zvuk dohromady zvyšují přesnost odpovědi.
Práce a kancelář: méně rutiny, více kontroly
Ve firmách patří multimodální modely k nejrychleji rostoucím nástrojům produktivity. Umějí přepisovat porady, shrnovat nahrané schůzky, analyzovat prezentace a porovnávat dokumenty s obrázky, grafy nebo tabulkami. Když zaměstnanec nahraje hodinu dlouhý záznam porady, model z něj během minut vytvoří stručný zápis s úkoly, termíny a jmény odpovědných lidí. V některých aplikacích už zvládá i porovnat obsah dvou verzí smlouvy a upozornit na změny v číslech nebo formulacích.
Významný posun přinesla také schopnost pracovat s videem. To se hodí ve výrobě, logistice i bezpečnosti. AI umí sledovat záznam z linky a upozornit na odchylku v procesu, například když balicí stroj začne opakovaně chybovat. V kancelářském prostředí zase dokáže z videohovoru vytáhnout důležité body a propojit je s kalendářem nebo firemním úložištěm. Podle průzkumů mezi velkými podniky zvyšuje nasazení multimodálních systémů produktivitu u některých administrativních rolí o 15 až 25 procent, zejména tam, kde se opakuje práce s dokumenty a záznamy.
Školy, zdravotnictví a veřejné služby
Multimodální modely se rychle prosazují i v oblastech, kde je potřeba kombinovat přesnost, vysvětlování a rychlou orientaci v datech. Ve školství dokážou analyzovat fotografii matematického příkladu, rozpoznat postup řešení a nabídnout žákovi nápovědu krok za krokem. Učitelé je využívají při přípravě výukových materiálů, tvorbě testů nebo úpravě textů pro různé věkové skupiny. V praxi to znamená, že stejný obsah lze během chvíle převést do jednodušší podoby nebo doplnit o obrázky a pracovní listy.
Ve zdravotnictví se multimodální AI používá opatrněji, ale její role roste. Modely pomáhají s předběžnou analýzou snímků, přepisem lékařských poznámek nebo tříděním pacientských podnětů. Nejsou náhradou lékaře, ale zkracují administrativu. Některé nemocnice uvádějí, že díky automatickému přepisu a strukturování poznámek ušetří zdravotníci desítky minut na jedno vyšetření. To je důležité v systému, kde chybí personál a každý ušetřený úkon má přímý dopad na dostupnost péče.
Ve veřejných službách se modely testují například pro analýzu formulářů, třídění podání nebo asistenci na úřadech. Pokud občan přiloží fotografii vyplněného dokumentu a přidá otázku hlasem, systém dokáže najít chybějící údaje a upozornit na formální nedostatky dřív, než se žádost odešle. Tím se snižuje počet vratek a zbytečných návštěv přepážek.
Co se změnilo oproti předchozím generacím
Hlavní rozdíl není jen v tom, že modely „vidí obrázky“. Nová generace je lepší v propojení různých zdrojů informací v jednom kroku. Když dostane fotografii, textový popis a krátké video, dokáže z nich vytvořit jednotný výstup. Zlepšila se také práce s delším kontextem. Některé modely zvládají v jedné konverzaci udržet desítky tisíc slov nebo několik minut audia, což je zásadní například při analýze dokumentace nebo delších porad.
Další novinkou je schopnost plánovat úkoly v několika krocích. Uživatel nemusí zadávat každý dílčí příkaz zvlášť. Model například vezme fotografii poškozeného kola, porovná ji s dostupnými návody, navrhne potřebné nářadí, odhadne cenu dílů a připraví seznam kroků. Ve firemní praxi to znamená, že AI už není jen odpovídač, ale spíš pracovní asistent, který si umí rozdělit problém na menší části.
Změnil se i způsob ovládání. Vedle psaní roste význam hlasu a kamery. Uživatelé častěji mluví, ukazují a doplňují. To snižuje bariéru pro seniory, děti i lidi, kteří nejsou zvyklí formulovat přesné dotazy. Právě tady leží jedna z největších výhod multimodálních modelů: přizpůsobují se tomu, jak lidé skutečně komunikují v běžném životě, ne naopak.
Limity, rizika a proč je potřeba obezřetnost
I v roce 2026 ale multimodální AI zůstává technologií s jasnými limity. Model může špatně přečíst rozmazaný obrázek, zaměnit podobné objekty nebo si domyslet detaily, které na vstupu nejsou. U videa se stále objevují chyby v časové návaznosti, například když systém správně rozpozná jednotlivé objekty, ale špatně vyhodnotí jejich pořadí. V medicíně, právu nebo bezpečnosti je proto nutná lidská kontrola.
Dalším problémem je soukromí. Fotografie z domácnosti, hlasové záznamy nebo pracovní videa mohou obsahovat citlivé údaje. Firmy proto zavádějí pravidla, co lze do modelu nahrávat a kde se data ukládají. Rostoucí důraz je i na ověřování zdrojů: multimodální modely mohou velmi přesvědčivě odpovědět, i když se mýlí. To je důvod, proč odborníci doporučují používat je jako asistenta, ne jako jediný zdroj pravdy.
V běžném životě tak multimodální modely přinášejí hlavně rychlost, pohodlí a lepší orientaci v informacích. Kdo umí správně zadat úkol a ověřit výsledek, získává nástroj, který šetří čas doma, v práci i při studiu. Kdo mu ale bez kontroly svěří důležitá rozhodnutí, riskuje chybu, která se může snadno skrýt za dobře znějící odpověď.